L'essentiel à retenir
- Le tracking server-side fait transiter les événements par un serveur contrôlé par l’annonceur avant de les envoyer aux outils d’analytics et aux régies, au lieu de les envoyer directement depuis le navigateur.
- Il récupère une grande partie des conversions perdues à cause des bloqueurs et des limites des navigateurs, prolonge la durée de vie des cookies first-party et donne le contrôle des données transmises à chaque partenaire.
- Il ne dispense pas du consentement : un traceur publicitaire reste soumis au choix de l’internaute, qu’il passe par le navigateur ou par un serveur.
- Il ne règle pas l’attribution : chaque régie continue de s’attribuer ses propres conversions, et des API de conversion mieux alimentées peuvent même augmenter le total des ventes revendiquées.
- Il demande un budget d’hébergement, des compétences techniques et une maintenance régulière, en particulier pour la déduplication entre événements navigateur et serveur.
En bref
Le tracking server-side, via Google Tag Manager côté serveur ou les API de conversion des régies, améliore la collecte : moins de pertes liées aux bloqueurs et aux navigateurs, des cookies plus durables, des données mieux maîtrisées. Il ne règle en revanche ni le consentement, ni la déduplication entre régies, ni l’attribution multi-leviers. Il complète une stratégie de mesure, il ne la remplace pas.
Le tracking server-side est devenu en quelques années une recommandation incontournable : les régies le conseillent, les agences le proposent et les outils se sont multipliés. Google Tag Manager côté serveur (sGTM), la Conversions API de Meta, les conversions améliorées de Google, les Events API de TikTok ou de Pinterest promettent tous la même chose : récupérer les conversions que le navigateur ne mesure plus.
La promesse est en partie tenue. Mais le server-side est souvent présenté comme la réponse à tous les problèmes de mesure : fin des cookies tiers, consentement, écarts entre régies, attribution. Ce n’est pas le cas. Avant d’investir, il faut savoir ce qu’il améliore réellement, ce qu’il laisse en l’état et les nouvelles questions qu’il pose.
Comment fonctionne le tracking server-side ?
Dans un tracking classique, dit client-side, chaque outil dépose son propre script dans le navigateur de l’internaute : le pixel de Meta, la balise Google Ads, le tag GA4, celui du partenaire d’affiliation. Chaque script envoie directement ses données au serveur de son éditeur.
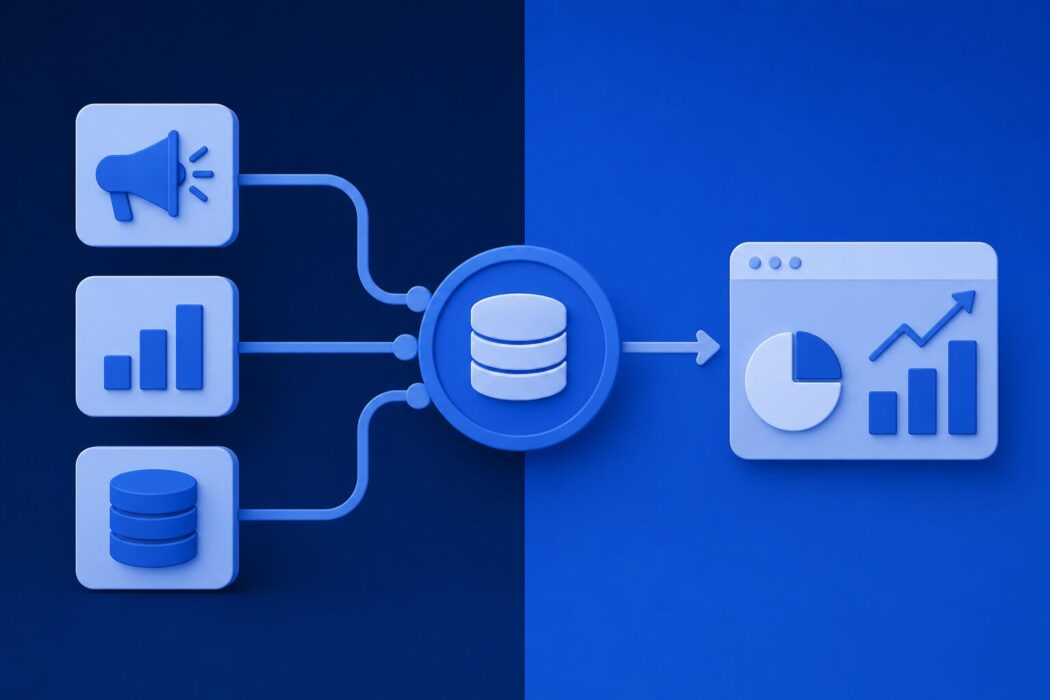
En server-side, le navigateur envoie les événements (vue de page, ajout au panier, achat) à un serveur de collecte hébergé sur un sous-domaine de l’annonceur, par exemple mesure.votresite.fr. Ce serveur les vérifie, puis les transmet à chaque outil. Google présente cette architecture comme un moyen d’améliorer à la fois les performances des pages, le contrôle des données personnelles et la qualité des données. Deux briques sont souvent confondues :
- Le conteneur serveur, comme sGTM : il remplace une partie des scripts du navigateur par un point de collecte unique, contrôlé par l’annonceur.
- Les API de conversion des régies : elles reçoivent des conversions envoyées de serveur à serveur, depuis le conteneur serveur, la plateforme e-commerce ou le back-office. Elles fonctionnent en complément du pixel, pas forcément à sa place.
Ce que le tracking server-side résout
Les pertes liées aux bloqueurs et aux navigateurs
Les bloqueurs de publicité et certaines protections des navigateurs empêchent les scripts des régies de se charger. Un point de collecte hébergé sur le domaine de l’annonceur est moins souvent bloqué, et les conversions envoyées par API depuis le back-office ne dépendent plus du navigateur. Bien configuré, le server-side réduit fortement ces pertes. Deux limites demeurent : certains bloqueurs reconnaissent aussi les conteneurs serveur, et une conversion non consentie ne doit pas être transmise.
Les résultats publiés vont dans ce sens : chez le distributeur d’articles de running i-Run, Addingwell fait état de 35 % de données collectées en plus et de 16 % de conversions attribuées à Meta en plus après le passage au server-side.
Des cookies first-party plus durables
Safari limite à 7 jours la durée de vie des cookies déposés en JavaScript. Un cookie déposé par un serveur du domaine de l’annonceur peut être conservé plus longtemps, ce qui améliore la reconnaissance des visiteurs qui reviennent acheter plusieurs jours après leur premier clic. Cette amélioration suppose une configuration correcte : depuis Safari 16.4, les cookies déposés par un serveur hébergé sur une adresse IP trop éloignée de celle du site principal sont limités eux aussi.
Le contrôle des données transmises
Avec un conteneur serveur, l’annonceur décide de ce que reçoit chaque partenaire : il peut supprimer l’adresse IP, retirer des paramètres d’URL, hacher une adresse e-mail avant de l’envoyer ou ne transmettre que les événements utiles. C’est un progrès pour la minimisation des données exigée par le RGPD, à condition de configurer ces règles.
Des pages plus légères
Remplacer une dizaine de scripts par un point de collecte unique réduit le poids des pages et le temps de chargement, avec un effet possible sur le taux de conversion et le référencement naturel.
Ce que le tracking server-side ne résout pas
Le consentement
Passer par un serveur ne change pas les règles : un traceur publicitaire reste soumis au consentement de l’internaute, qu’il soit déclenché dans le navigateur ou relayé par un serveur. Piano le rappelle dans sa documentation : que l’information soit transmise depuis un navigateur ou depuis un serveur, le consentement de l’internaute doit être obtenu. Le conteneur serveur doit donc recevoir le choix de l’internaute et le respecter pour chaque destination. Utiliser le server-side pour transmettre aux régies les données des internautes qui ont refusé expose l’annonceur à une sanction. Les signaux du Consent Mode restent nécessaires, comme nous l’expliquons dans notre article sur le Consent Mode v2.
La suppression des identifiants de clic
Depuis Safari 26, la Link Tracking Protection retire les gclid, fbclid et msclkid des URL avant même le chargement de la page. Le serveur ne peut pas récupérer un identifiant qui n’est jamais arrivé. Les UTM, eux, sont conservés : ce sont eux qu’il faut renforcer. Nous détaillons les bonnes pratiques face à la suppression des identifiants de clic.
La déduplication entre régies
Une API de conversion mieux alimentée permet à chaque régie de rattacher davantage de ventes à ses publicités. Meta, Google et TikTok peuvent alors revendiquer la même commande, chacun avec ses propres fenêtres d’attribution. Le server-side augmente souvent la somme des conversions déclarées, sans dire laquelle de ces régies a réellement déclenché la vente. Nous expliquons d’où viennent ces écarts entre régies et analytics.
L’attribution multi-leviers et le post-view
Le server-side améliore la collecte, pas la lecture des données. Les walled gardens continuent de mesurer leurs propres performances, y compris les conversions après simple affichage, et ne partagent pas les parcours complets. Répartir les ventes entre les leviers reste le travail d’une solution d’attribution indépendante.
Les erreurs de configuration
Un tag mal paramétré côté navigateur reste mal paramétré une fois relayé par un serveur. Montant transmis incohérent, identifiant de commande absent, événement déclenché deux fois : le server-side ne corrige rien de tout cela, et il ajoute un nouvel endroit où une erreur peut se produire.
Récapitulatif : ce qui change, ce qui ne change pas
| Sujet | Effet du tracking server-side |
|---|---|
| Pertes liées aux bloqueurs | Fortement réduites |
| Durée de vie des cookies dans Safari | Allongée, si le serveur est correctement configuré |
| Contrôle des données envoyées aux partenaires | Nettement amélioré |
| Poids des pages | Réduit |
| Consentement | Aucun changement : il reste obligatoire |
| Identifiants de clic supprimés par Safari | Aucun changement |
| Conversions revendiquées par plusieurs régies | Aucun changement, voire davantage de doublons |
| Attribution multi-leviers et post-view | Aucun changement |
Les points de vigilance avant de passer au server-side
- Dédupliquer navigateur et serveur : le plus sûr est d’envoyer chaque événement à chaque outil par un seul chemin. C’est le cas quand le conteneur serveur relaie vers GA4 ou Google Ads les données reçues du navigateur, au lieu de les envoyer une seconde fois. Meta recommande au contraire d’envoyer les conversions à la fois par le pixel et par la Conversions API. Il faut alors transmettre le même nom d’événement et le même identifiant (event_id) dans les deux envois, puis contrôler dans le gestionnaire d’événements que les doublons sont bien écartés. Google déduplique aussi les achats grâce à l’identifiant de transaction, avec des limites : GA4 ne le fait que pour les achats d’un même utilisateur, et Google Ads uniquement au sein d’une même action de conversion. Piano Analytics recommande lui aussi de ne pas envoyer deux fois le même événement sans stratégie de déduplication claire, sous peine de gonfler les mesures.
- Prévoir le coût : l’hébergement du conteneur serveur est facturé au volume de requêtes, chez Google Cloud ou chez un prestataire spécialisé. Ajoutez le temps de mise en place et de maintenance.
- Choisir le bon hébergement : un sous-domaine du site, une adresse IP cohérente avec celle du site principal et un hébergement dans l’Union européenne simplifient à la fois la durée de vie des cookies et la conformité.
- Documenter les flux : listez les données envoyées à chaque partenaire, avec leur base légale. Le registre des traitements doit refléter cette nouvelle architecture.
- Mesurer le gain : comparez les conversions remontées avant et après la mise en place, par navigateur et par régie, et rapprochez-les des commandes du back-office. Un gain affiché par une régie n’est pas forcément une vente supplémentaire. Avec TrackAd, cette comparaison est immédiate : les données analytics et celles des sources de trafic étant réunies dans une même interface, l’évolution des sessions, des conversions et des ventes par régie et par navigateur se lit directement, avant et après la mise en place.
Pour les contrôles à mener régulièrement, consultez notre article sur les vérifications essentielles de vos données analytiques.
Impact TrackAd
TrackAd réunit dans une même plateforme vos données analytics, celles de votre CRM et celles de vos sources de trafic. La plateforme se connecte aux outils de tracking déjà en place quand leur niveau de collecte est suffisant, ou s’appuie sur son propre traqueur, avec une collecte first-party sous le domaine de la marque. L’attribution repose sur les UTM et les codes de tracking maîtrisés par l’annonceur, et non sur les identifiants de clic des régies.
TrackAd rapproche ensuite les conversions collectées des ventes réelles par API, à partir des données commerciales de l’annonceur. Ce rapprochement fait apparaître les conversions manquantes, celles comptées deux fois entre navigateur et serveur, et celles revendiquées par plusieurs régies. Grâce aux modules de déduplication et d’attribution, chaque vente n’est attribuée qu’une fois, et les coûts remontés par les régies sont comparés aux ventes réelles pour une performance consolidée.
Le server-side améliore les signaux envoyés aux régies ; TrackAd vérifie ce qu’ils produisent réellement. Nous détaillons pourquoi TrackAd complète Google Analytics 4. Pour évaluer votre dispositif de tracking avec nos équipes, vous pouvez demander une démo.
Conclusion
Le tracking server-side est une amélioration utile de la collecte : moins de pertes, des cookies plus durables, des données mieux maîtrisées. Il ne change rien aux obligations de consentement, ne protège pas les identifiants de clic et ne dit pas quelle régie a réellement généré une vente. Les annonceurs qui l’associent à des UTM rigoureux, à une déduplication fiable et à une attribution indépendante en tirent le meilleur parti.
Le tracking server-side en 5 questions
Qu’est-ce que le tracking server-side ?
C’est une méthode de collecte qui fait transiter les événements d’un site (vues de page, ajouts au panier, achats) par un serveur contrôlé par l’annonceur, avant de les transmettre aux outils d’analytics et aux régies publicitaires.
Le tracking server-side dispense-t-il du consentement ?
Non. Un traceur publicitaire reste soumis au consentement de l’internaute, qu’il soit déclenché dans le navigateur ou relayé par un serveur. Le conteneur serveur doit respecter le choix exprimé dans le bandeau de consentement.
Quelle différence entre server-side GTM et Conversions API ?
Server-side GTM est un conteneur qui centralise la collecte sur un serveur de l’annonceur et redistribue les données. La Conversions API de Meta est un point d’entrée qui reçoit des conversions envoyées de serveur à serveur. Le premier peut alimenter la seconde.
Comment éviter les doublons entre pixel et API de conversion ?
Le plus sûr est d’envoyer chaque événement à chaque outil par un seul chemin. Quand le navigateur et le serveur envoient tous les deux la même conversion, comme le recommande Meta, il faut transmettre le même nom d’événement et le même identifiant dans les deux envois, puis vérifier dans l’outil de la régie que les doublons sont bien écartés.
Le tracking server-side règle-t-il les écarts entre régies et analytics ?
Non. Il améliore la collecte, mais chaque régie continue d’appliquer ses propres fenêtres et de s’attribuer les ventes auxquelles elle a contribué. Seules une déduplication et une attribution indépendantes rapprochent ces chiffres des ventes réelles.